AI好奇记|想要换掉RAG,可试试看hindsight
今早7点便坐到电脑前,但直到7点35分这一刻才敲下这第一句话。
前面的35分钟,20分钟刷知乎推荐,看到的内容很多,记住的只有“安史之乱的源头是武则天”一条;15分钟简单看两条Trending。
这懒散,最大可能源于今天已经是放假的第三天——懒散习惯了。
一、GitHub流行趋势#
话不多说,言归正传,首先依然是GitHub的流行趋势。
增星超过5K的,依然有ECC(https://github.com/affaan-m/ECC),是否应该花心思去好好研究一下呢?
我去读了一下作者的简要介绍(https://x.com/affaan/status/2012378465664745795),收获的认知是这样的:ECC最初专为Claude Code设计,它是一个很全面的开发者辅助工具:如何规划,如何写代码,如何测代码,以及如何review。
上周说想要试一下的两个工具,我只先尝试了阿里的review,得出的结论是:对现在的我来说,可用性不太强,我还是更喜欢在Codex中调用一下自己的“多轮review” Skill。
Ocra还未尝试,它依然在本周的流行趋势前列。
1、https://github.com/cloudflare/security-audit-skill#
A coding-agent skill for multi-phase security audits with independently verified, machine-readable findings.
一个用来做安全审计的Skill。
2、https://github.com/paperclipai/paperclip#
The open-source app everyone uses to manage agents at work.
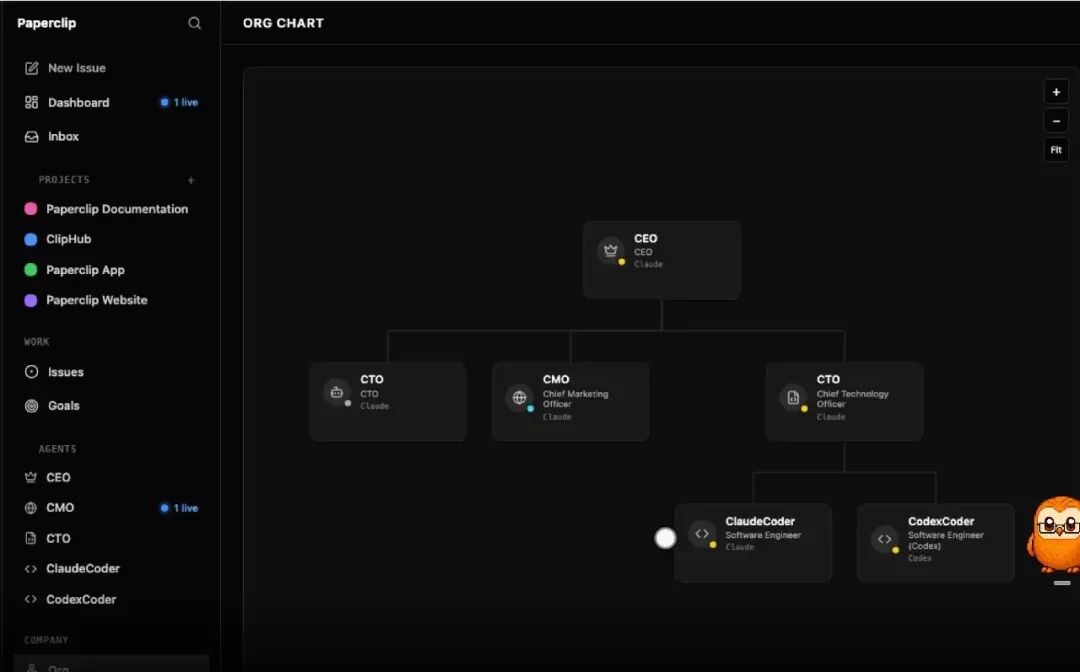
这个感觉有点好玩,给正做事情的Agent们划分角色与组织,为方便自己管理,也适合“一人公司”。
3、https://github.com/vectorize-io/hindsight#
Hindsight: Agent Memory That Learns.
读完hindsight的介绍,我所想到的是,这是一个拟人化的可代替RAG的系统,整体的思路都是:存数据、召回数据、将数据给大模型。
差异有以下这些:
| 维度 | 传统 RAG (Retrieval-Augmented Generation) | Hindsight 记忆系统 |
|---|---|---|
| 定位与目标 | 知识检索 :专注于从静态文档库(PDF/Markdown 等)中查找相关段落。 | Agent 增量学习 :专注于在交互过程中随时间积累、理解并演进记忆。 |
| 存储组织 | 主要是扁平化的向量数据库(Chunks + Embeddings),部分结合知识图谱。 | 拟生记忆结构 :包含事实、经验、演化信念(Observations)和心智模型(Mental Models)。 |
| 更新机制 | 静态或追加式,新旧知识容易冲突,无法自动“消化”和修正历史信息。 | 后台整理与演化 :新信息入库会强化、削弱或补充现有的 Observation,自动修正认知。 |
| 检索方式 | 单一向量相似度匹配,或简单的向量+关键词混合搜索。 | 四维并行检索 (向量 + 关键词 + 图谱 link + 时间维度)结合 Cross-Encoder 重排。 |
| 思考深度 | 只做“找资料”(Lookup),把原始文本丢给 LLM。 | 提供 Reflect(反思) 操作,支持 Agent 对已有记忆做提炼与深层因果推导。 |
| 启动性能 | 每次都需要经过完整的“搜索-拼接 Prompt”过程,消耗 token 且有延迟。 | 支持 Mental Models ,Agent 启动时可直接像读内存一样读入预提炼好的总结。 |
总结来说: 传统 RAG 就像给 AI 挂载了一个外置搜索引擎 ,只负责“按关键词/语义找文段”;而 Hindsight 是给 AI 装上了一套海马体与大脑皮层 ,不仅能记住经历,还能在后台把分散的经历消化成知识与经验。
(以上表格复制于Gemini。)
二、一点资讯#
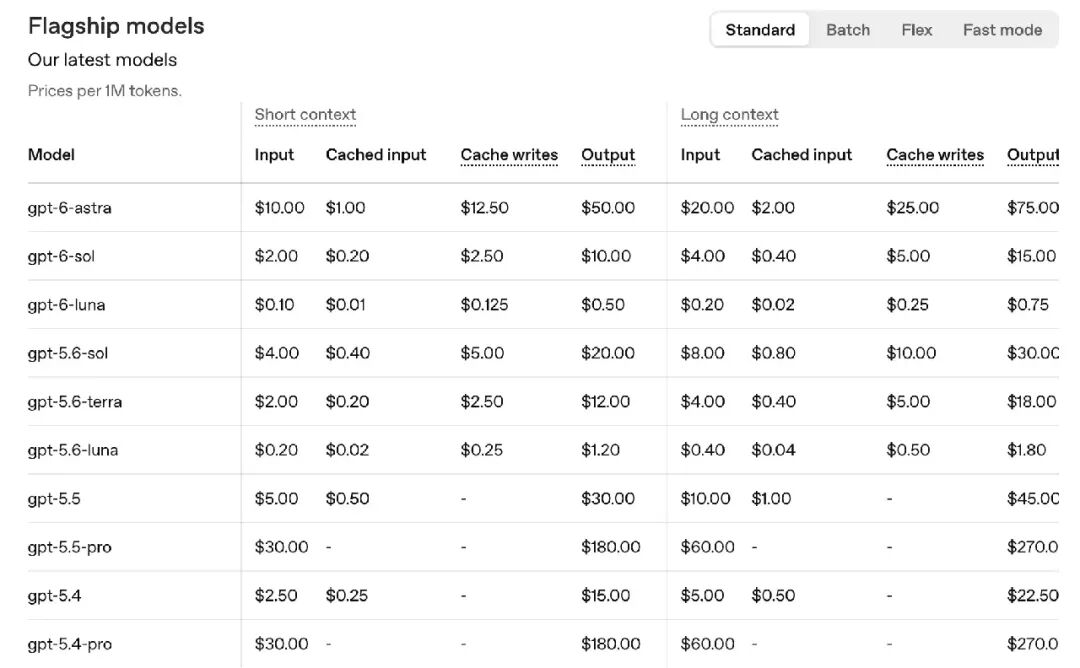
OpenAI在本周新发布了6 Sol和6 Luna。其中值得关注的一点是6 Sol的价格只是5.6 Sol的一半 ,至于效果的升级,我在网上暂时没有搜到很明确的结论。
模型界最近两周新出的很火爆关键词是Jev,这是一种全新的模型。
Jev 是一款专为自动化软件设计的系统一(System One)AI 模型,能将非结构化数据极速(70ms-500ms)、无幻觉地转化为类型安全且带精确置信度的结构化决策数据,供代码逻辑直接调用。
过去两年我的工作当中,一个很有意思的功能是意图识别,即让模型判断用户到底想做什么,然后走对应的分支逻辑。想要意图识别准确,往往需要来回调好多好多次提示词,而Jev,是专门做这件事情的。
最后,今儿还看见这样一个言论:
当我们知道TikTok花大价钱招聘神经科学和行为学工程师,以及说服性设计专家,来破解我们多巴胺回路时,我每天都在庆幸自己从未在这个平台上创建账户,哈哈。
看看这些fMRI和EEG科学研究,它们非常清楚地显示,短视频格式直接攻击前额叶皮层和前扣带回(顺便说一句,这些区域负责执行控制、决策和注意力调节)。
要知道,通过向大脑轰炸不可预测的微刺激,算法会改变灰质密度,降低默认模式网络的活动,而且这种持续的过度刺激会导致慢性无法进行长期思考,并摧毁专注能力——对我来说,这两种能力在当今时代简直是字面意义上的必需品,用来构建未来。
总之,我认为拒绝进入这个系统,简直就是简单地保护自己的认知自主性和注意力主权,面对这种量身定制的成瘾工程。
我是相信这个言论的,特别是小孩子,请少刷短视频。
本周的AI好奇记到此结束,这两小时的学习依然处于探索期。本周有一点小小改变,新增X的Trending。 (原文链接,更新于2026-09-27。)