休假回来,Codex Token用量翻了一倍:我做了4项调整
8月休假回来,我的Token使用量相较休假之前翻了一倍,这使得咱们的Token管理员天天天天地问我:“你今天干嘛了啊?怎么又用了这么多?”
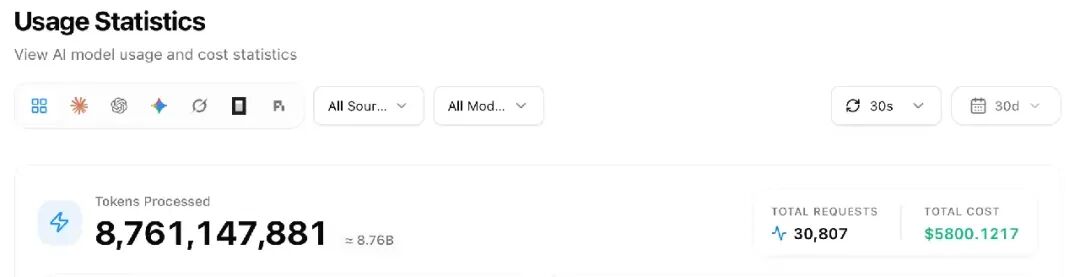
由此,最近一段时间的工作间隙,为了减少自己的Token用量,我做过一些尝试。昨天似乎取得一些进展,整理本周《AI好奇记》间隙,忽然想到可以为这些尝试做一次整理,且留作后续参考。
1、review的锅?#
Code review,是我写代码过程中很喜欢做的一件事情,review总能帮助我提前规避掉许多问题。由此,无论是古法编程时代、Cursor写代码时代,还是现在的Codex时代,提交代码之前我必做的一件事情,便是再做一次review。
使用Codex最初,我和Codex的对话大概是这样的:
我:好吧,我们来做一次review
Codex:好的,经过查看,我看到有这样一些问题(P0、P1……),建议提交代码之前先做修复。
我:(看一眼,做一些确认之后),如上,fix
Codex:好的,修好了。
我:行,再做一轮review
Codex:好的,经过查看,我看到有这样一些问题(P0、P1……),建议提交代码之前先做修复。
我:fix
……
即,似乎每一轮review,都能review出来改进空间。
为省事,有一段时间,我直接用上loop大法:
review 你的修改,看看是否有遗漏或有问题的地方,若有就修改。不断重复这个 review 的过程,直到你认为代码不需要再调整。
loop大法当然耗费Token,于是我的第一个改进措施,是将loop固定为只做三轮:
默认在当前 Agent、当前任务中执行,不自动新建或 fork 任务。
第一轮全面检查并修复,第二轮换成边界、回归、并发、安全等风险视角复查。
只有第二轮发现新的实质问题时才进入第三轮,否则立即停止,并且绝不进行第四轮。
每轮都只读取目标 diff 和必要证据,修复后运行定向验证,样式建议或重复问题不会触发下一轮。
这改进有效果,但不多。
2、总是双倍?#
Token管理员说:“为啥你的请求上面总是有一个x2的标记呢?”
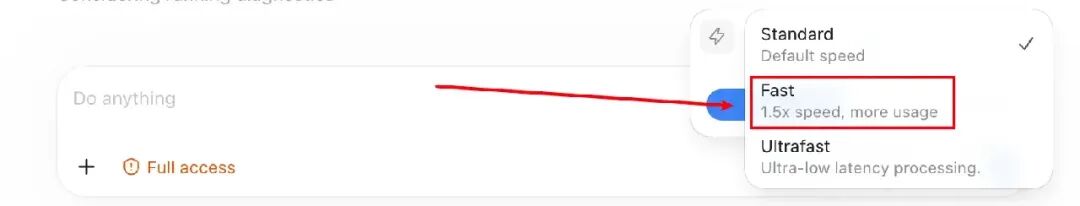
这单纯是一个Codex设置项,改回去Standard就好。改回去,Codex跑任务的速度确实慢了许多。
3、skill太多?#
我们排查问题的测试基线,是在Codex中问一个“你好”,看看这个请求所使用的Token量有多少,每个人的“你好”花费都不相同。
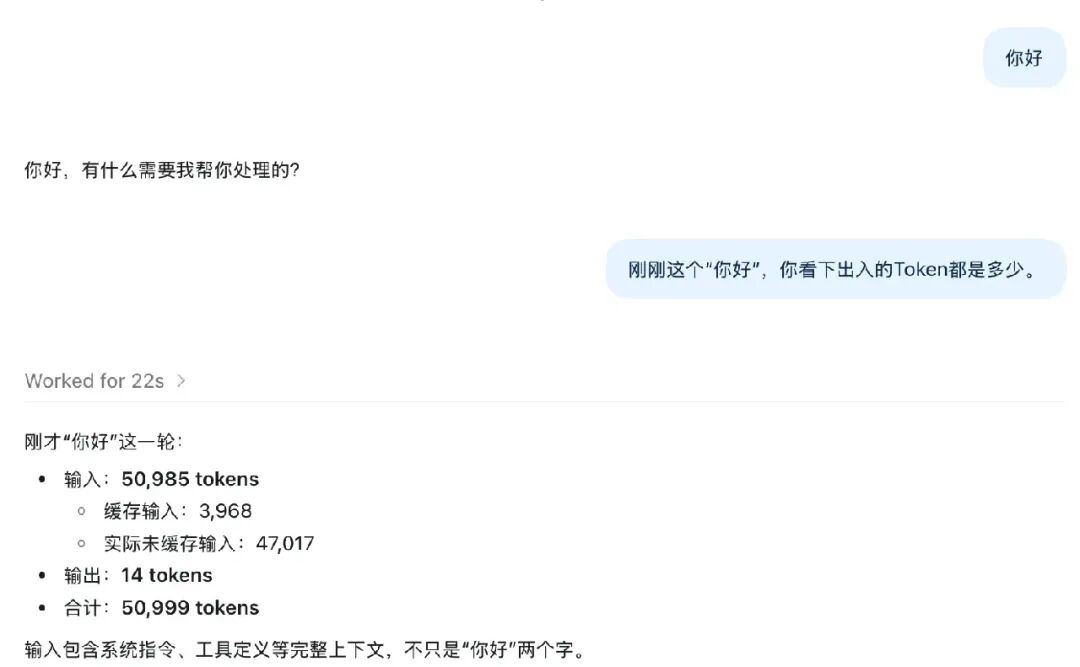
我的“你好”,相较其他同事更多的原因,是我本地安装的Skill太多,每个问题,Codex都将会把Skill的索引带给模型。(“嗐,看见好用的Skill当然要试试啦。”)
.codex/config.toml是Codex的配置文件,放在用户目录(如我的Mac下:/Users/name/.codex/config.toml)则全局生效,放在项目目录则项目生效。
Codex此处给予的第一个改动方向是,限制Skill的索引大小:
# config.toml下面添加此配置
[skills]
max_context_tokens = 500
另外,我本地的工具也很多,于是Codex的第二个改动方向是,按项目启用工具,在各自项目的config.toml下面加上使用工具。
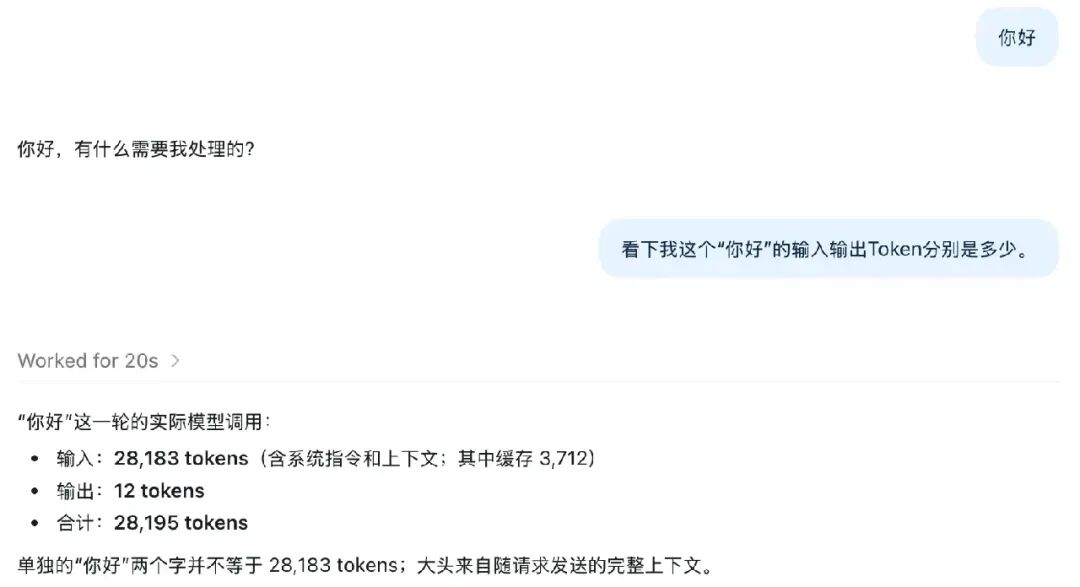
上面一番操作下来,让“你好”的Token从51k降低到28k。
4、上下文太长?#
真实的Token消耗,并不发生在全局对话框中,最大头的Token,永远是超长上下文 ,其他同事提供了另外的解决方向。
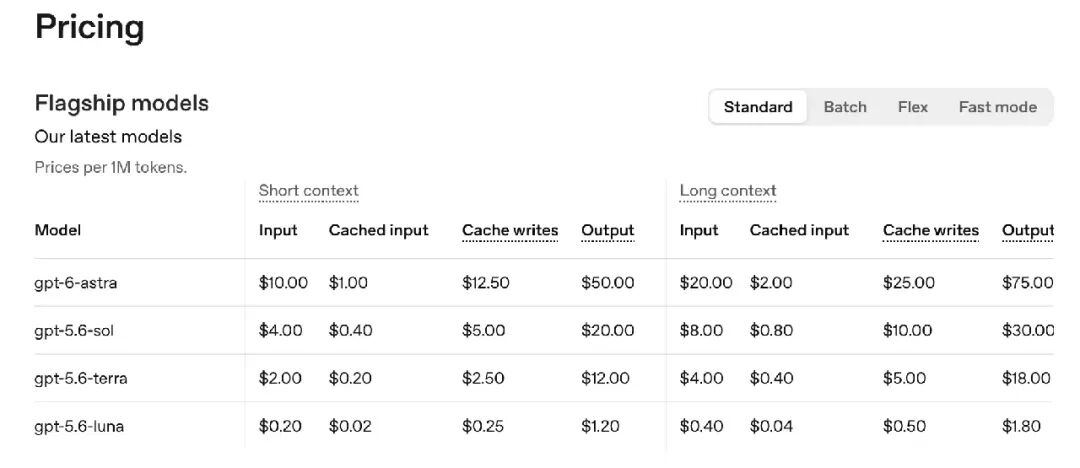
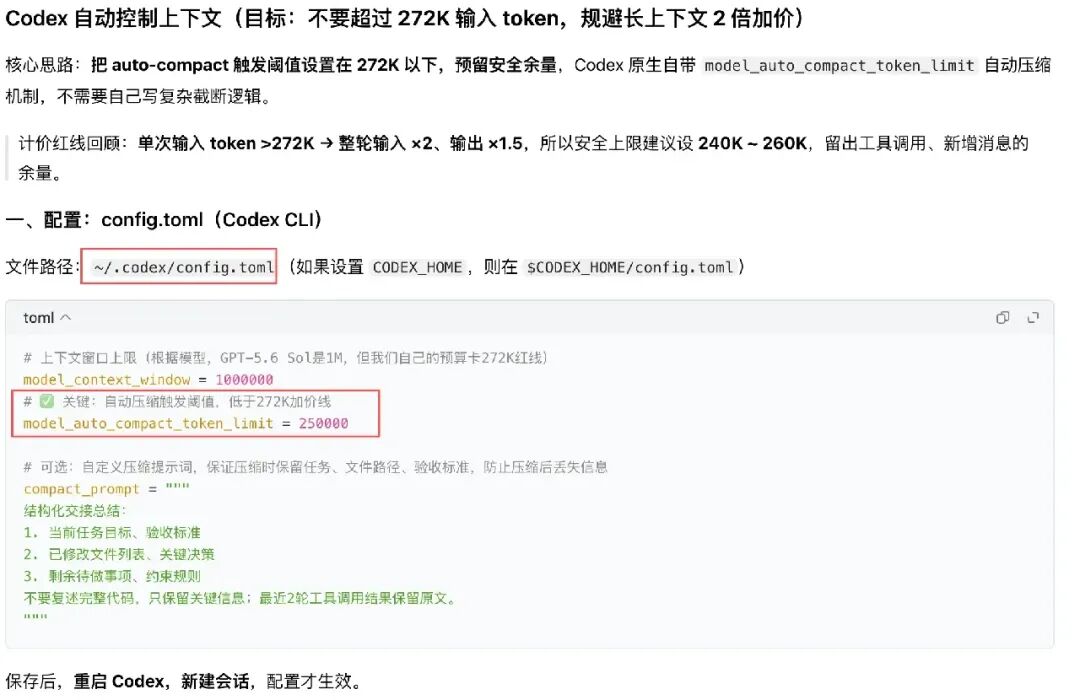
如上图,当模型进入超长上下文之后,价格直接翻倍,由此,同事的解决方案是:
另外,很久以前为减轻Codex读代码压力,我还使用CodeGraph提前建立代码索引。
https://github.com/colbymchenry/codegraph
Pre-indexed code knowledge graph, auto syncs on code changes, for Claude Code, Codex, Gemini, Cursor, OpenCode, AntiGravity, Kiro, CoPilot, and Hermes Agent — fewer tokens, fewer tool calls, 100% local
CodeGraph先将代码库解析并构建为包含符号、调用链与依赖关系的本地知识图谱。Codex无需逐个读取文件去“摸索”代码结构,只需通过一次图谱查询,就能准确获取所需的代码与上下文信息,从而减少了大量重复的探索性Token。
5、Codex的补充#
我将上面内容交给Codex review,它提出好些值得完善的点,但被认为大部分需要完善的点,Codex知道就好,不用在本篇当中赘述,只摘出两点补充到此处。
还建议加入第五节:“Token 审计本身也可能浪费 Token”。咱们后来最有效的尝试,是把 SQLite/JSONL 的统计逻辑固化为本地脚本和 codex-token-audit Skill,由脚本输出短报告,而不是让模型反复读取完整历史。
以下配置和费率核对时间为 2026 年 9 月 19 日,Codex 更新较快,后续请以官方文档为准。
–
以上操作做完,肉眼看起来Token消耗量似乎有降低的,且待未来继续观察。(如果有更好的处理方式,欢迎评论区留言哟~) (原文链接,更新于2026-09-19。)